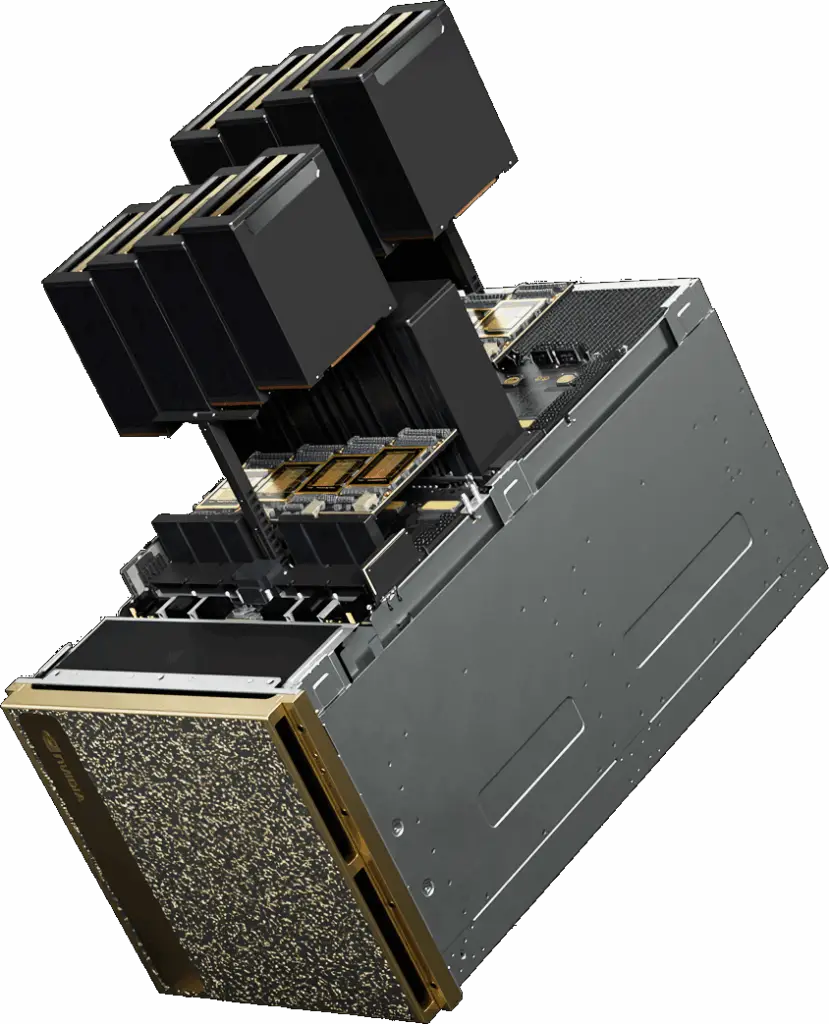
NVIDIA DGX B200 – nu tillgänglig för POC och utvärdering
Aixia är stolta över att meddela att vi nu har den senaste generationens AI-infrastruktur, NVIDIA DGX B200, i full drift i vårt datacenter. Med denna satsning stärker vi vår position som ledande inom avancerad AI- och HPC-lösningar i Norden.
En ny nivå av AI-prestanda
DGX B200 är baserad på NVIDIAs nya Blackwell-arkitektur och levererar upp till 72 petaFLOPS för träning och 144 petaFLOPS för inferens. Systemet är utrustat med åtta NVIDIA Blackwell GPU:er och totalt 1 440 GB HBM3e GPU-minne, vilket möjliggör hantering av de mest krävande AI-arbetsbelastningarna, inklusive stora språkmodeller och generativ AI.
Teknisk specifikation i korthet:
GPU: 8x NVIDIA Blackwell
GPU-minne: 1 440 GB HBM3e
CPU: 2x Intel Xeon Platinum 8570 (112 kärnor totalt)
Systemminne: Upp till 4 TB
Lagring: 2x 1,9 TB NVMe M.2 (OS) + 8x 3,84 TB NVMe U.2 (data)
Nätverk: 8x NVIDIA ConnectX-7 VPI (upp till 400 Gb/s)
Effektförbrukning: ~14,3 kW
Formfaktor: 10U
Systemet levereras med NVIDIA AI Enterprise och NVIDIA Base Command, vilket ger en komplett mjukvarustack för AI-utveckling och drift.
Proof of Concept – i vårt datacenter eller hos er
Vi erbjuder nu företag möjligheten att genomföra proof of concept (POC)-projekt med DGX B200:
I vårt datacenter: Testa och utveckla era AI-modeller i en optimerad miljö med tillgång till vår expertis.
På plats hos er: Utvärdera DGX B200 i er egen infrastruktur för att se hur den integreras i era arbetsflöden.
Oavsett val ger vi er stöd genom hela processen, från planering till genomförande.
Kontakta oss för mer information
Är ni intresserade av att utforska hur NVIDIA DGX B200 kan accelerera era AI-initiativ? Kontakta oss på Aixia för att diskutera era behov och hur vi kan hjälpa er att realisera dem.