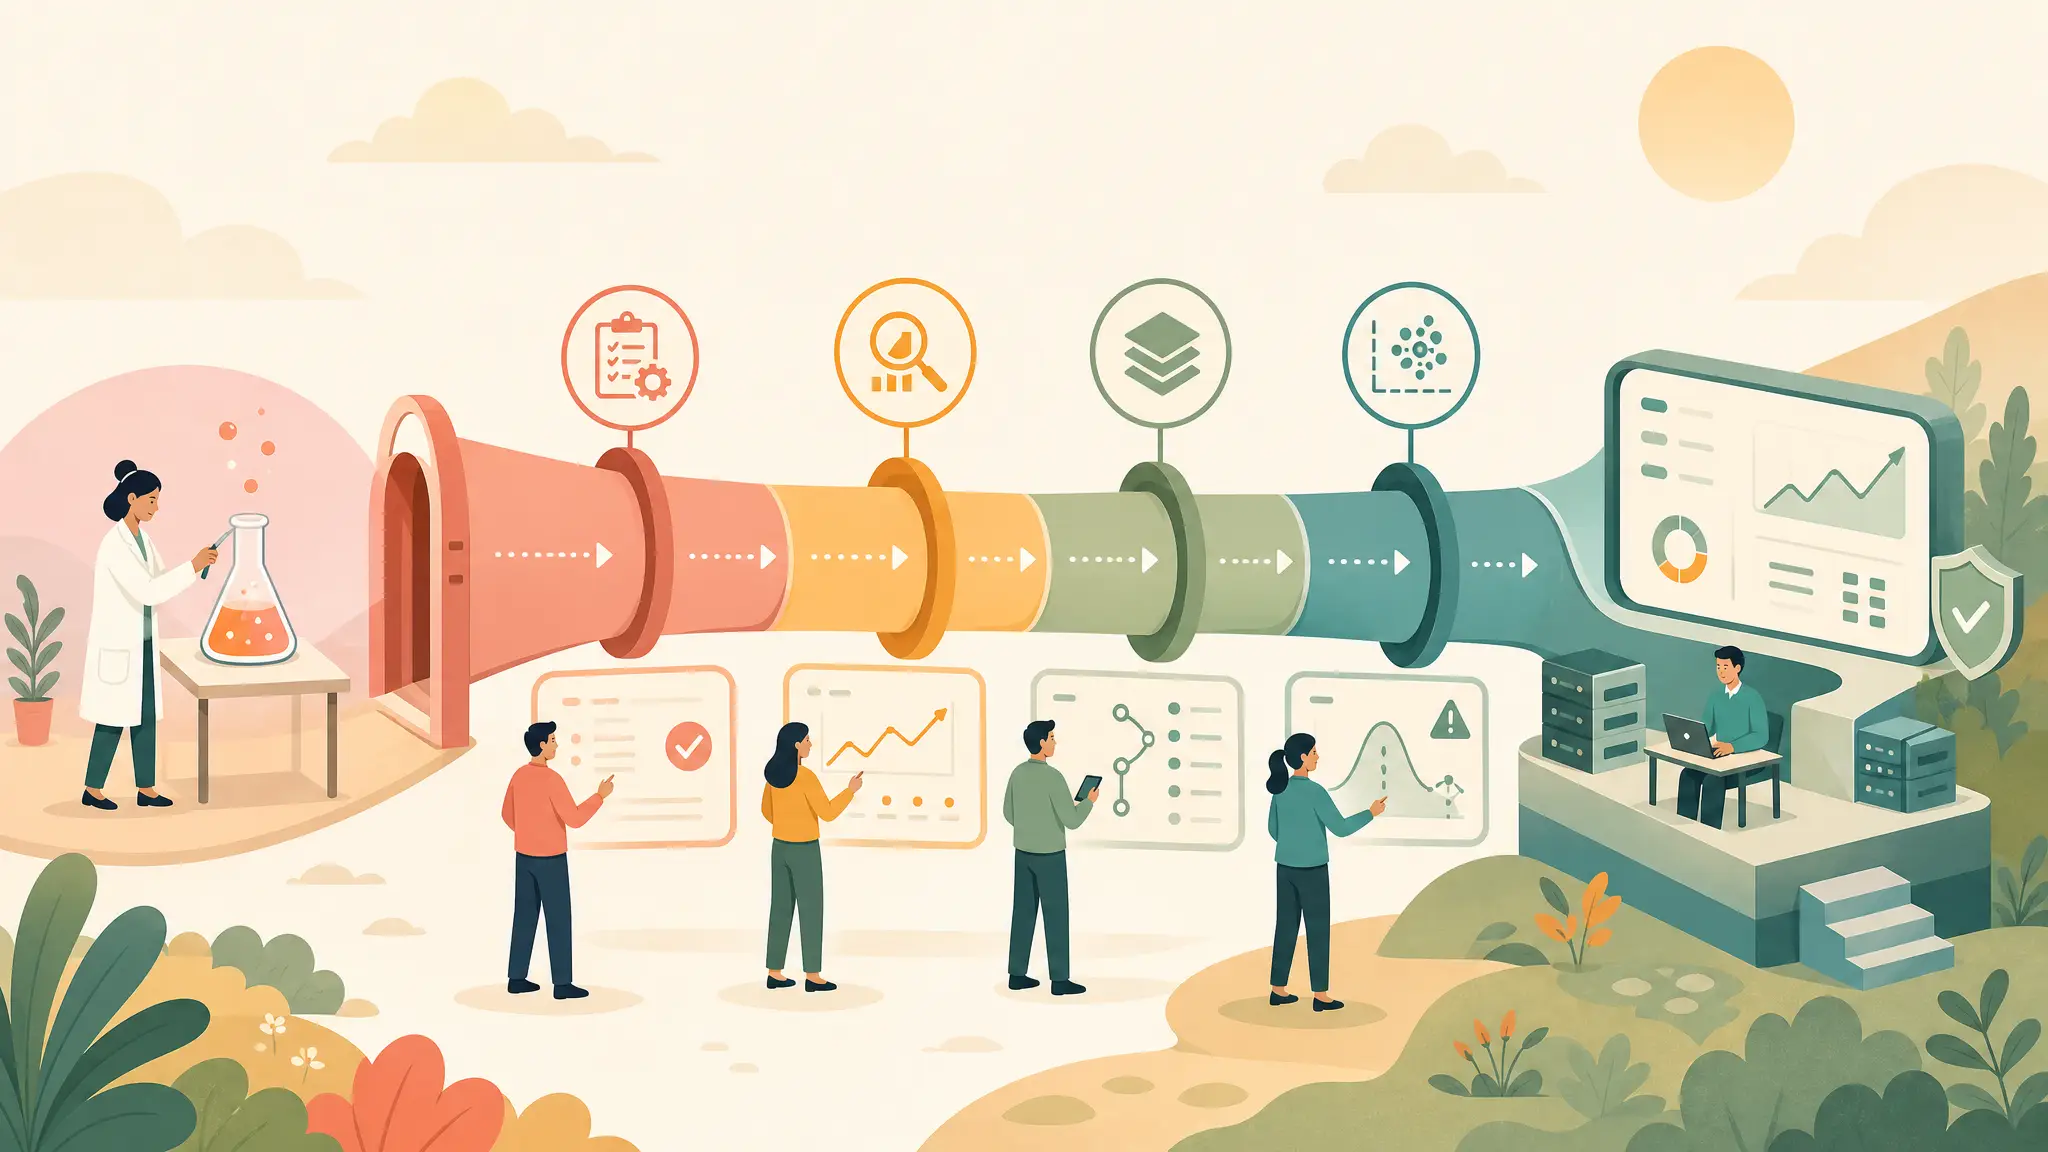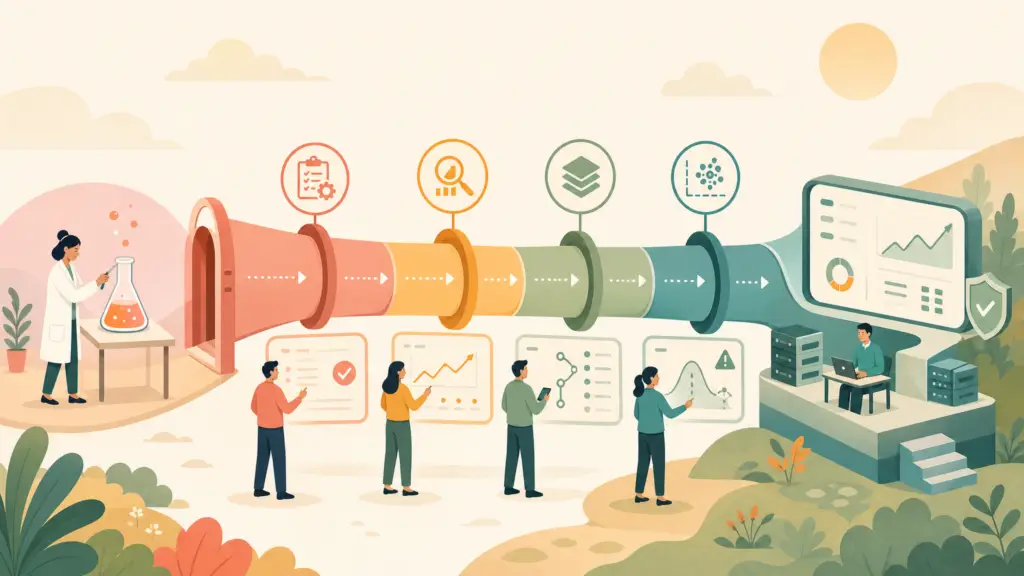
Att bygga en AI-modell som fungerar i en pilot är numera ganska enkelt. Att få samma modell att fungera stabilt i produktion, månad efter månad, är något helt annat. Många organisationer har i dag lyckade piloter bakom sig, men betydligt färre har tagit steget vidare till drift.
Orsaken är sällan själva modellen. Det som brister är allt runt omkring. Ingen har riktig koll på vilken data och vilken modellversion som används, ingen märker när resultaten börjar försämras och det är oklart vem som ansvarar när något förändras. Här går vi igenom de vanligaste fallgroparna när AI ska skalas, och vad som krävs för att undvika dem.
Varför piloter fastnar
En pilot byggs ofta för att bevisa att något är möjligt: ett litet team, ett avgränsat dataset och en notebook på en arbetsstation eller en enskild GPU-server. Det är ett bra sätt att komma i gång, men det skapar ett arbetssätt som inte håller när modellen ska användas på riktigt.
I produktion gäller andra villkor. Modellen ska gå att uppdatera utan att något går sönder, resultaten ska gå att förklara och upprepa, och någon ska märka om kvaliteten försämras. Flera team ska kunna dela på samma infrastruktur, och kraven på säkerhet och spårbarhet ökar. Det som fungerade för en datascientist fungerar sällan för tio.
Glappet mellan de två världarna är precis det MLOps handlar om. Det är inte ett verktyg utan ett sätt att arbeta, där data, kod, modeller och infrastruktur hanteras med samma disciplin som annan mjukvara i produktion.
De fem vanligaste fällorna
Nästan alla haverier vi ser går att härleda till samma fem områden.
1. Ingen koll på data och modellversion. Den vanligaste frågan som ingen kan svara på är: vilken data tränades den här modellen på? I många piloter hanteras koden i Git, men datan ligger i en mapp som skrivits över flera gånger och modellen sparas som en fil med ett datum i namnet. Det fungerar så länge samma person sitter kvar och minns hur det gick till. När modellen ska till produktion räcker det inte. Ni behöver kunna återskapa en modell exakt, jämföra två versioner och backa till en tidigare version om något går fel, vilket kräver att data, kod, konfiguration, beroenden och den färdiga modellen sparas och spåras tillsammans. Ett praktiskt första steg är ett modellregister där varje träningskörning kopplas till sitt dataset och sina parametrar. Lika viktigt är miljön: en modell tränad med en viss ramverks- och CUDA-version kan bete sig annorlunda i en annan. Containerbaserade miljöer som är identiska i utveckling och produktion tar bort en stor del av den osäkerheten.
2. Ingen övervakning efter driftsättning. I traditionell mjukvara märks det oftast när något går sönder. En AI-modell kan däremot fortsätta svara utan felmeddelanden och samtidigt leverera allt sämre resultat. Det gör övervakning till en helt annan uppgift. Modellövervakning behöver omfatta flera nivåer: svarstider, felfrekvens och resursanvändning på den tekniska nivån, att indata ser ut som förväntat på datanivån, och att förutsägelserna fortfarande håller kvalitet på modellnivån. Det sista är svårast, eftersom det korrekta svaret ofta inte är känt förrän långt senare. Bestäm därför i förväg vilka mått som ska följas, vilka trösklar som ska larma och hur återkopplingen från verksamheten samlas in.
3. Modell-drift som ingen upptäcker. Modeller tränas på historisk data, men världen står inte still. Kundbeteenden förändras, sensorer byts ut, nya produkter tillkommer och processer ändras. Det leder till modell-drift: modellen presterar gradvis sämre eftersom verkligheten inte längre liknar träningsdatan. Drift kan smyga sig på under månader utan att någon märker det, och det farliga är inte att den uppstår – det gör den nästan alltid – utan att den upptäcks sent. Då har felaktiga beslut redan fattats och förtroendet för AI-lösningen hunnit skadas. Lösningen är att behandla omträning som en planerad del av livscykeln, inte som en nödåtgärd: följ fördelningen i indata och utdata över tid, larma vid avvikelser och ha en färdig process för att träna om, validera och driftsätta en ny version.
4. Infrastruktur byggd för experiment. Under piloten har ofta ett team en GPU-server för sig själv. När fler team och modeller tillkommer uppstår konkurrens om resurserna. Utan gemensam schemaläggning slutar det ofta med att GPU:er reserveras ”för säkerhets skull” och står oanvända, medan andra team väntar i kö. Vi ser regelbundet miljöer där dyr hårdvara har låg utnyttjandegrad samtidigt som utvecklarna upplever brist på kapacitet. En produktionsplattform behöver kunna fördela resurser mellan team och projekt, prioritera produktionsjobb framför experiment och ge en samlad bild av vad som körs var, och samtidigt möta de säkerhetskrav som gäller, vilket för många innebär att data och modeller ska stanna i egen miljö.
5. Oklart ägarskap. Den kanske mest underskattade fällan är organisatorisk. Datascientists bygger modellen, IT driftar infrastrukturen och verksamheten använder resultatet. Men vem ansvarar för att modellen fungerar i produktion? Vem tar beslutet att träna om? Vem svarar när en förutsägelse visar sig vara fel? Utan tydliga svar hamnar modellen i ett mellanläge där ingen riktigt äger den. Sätt därför ägarskapet innan modellen driftsätts: varje modell i produktion bör ha en namngiven ägare, definierade kvalitetsmått och en överenskommen process för förändringar. Det låter byråkratiskt, men är i praktiken det som gör att modellen överlever när piloten är slut.
Så angriper AiQu problemen
Vi utvecklade AiQu, vår egen MLOps-plattform, eftersom vi gång på gång såg samma mönster hos kunder: bra modeller och bra hårdvara, men inget som band ihop dem i drift. AiQu ligger mellan infrastrukturen och de team som arbetar med AI och hjälper till med flera av fällorna ovan:
- Identiska miljöer. Standardiserade, containerbaserade arbetsmiljöer gör att utvecklingsmiljön speglar produktionsmiljön, vilket gör resultat lättare att återskapa.
- Delad och styrd GPU-kapacitet. Schemaläggning och resursstyrning fördelar GPU:erna mellan team och projekt, så att hårdvaran används i stället för att stå reserverad.
- En samlad bild. Alla workloads och deras resursanvändning syns på ett ställe, vilket gör det lättare att övervaka och prioritera.
- Data som stannar hemma. AiQu kan köras helt i egen miljö eller i ett svenskt datacenter, för organisationer med krav på datasuveränitet.
- Verktyg som hänger ihop. I stället för att ersätta etablerade verktyg för experimentspårning och modellregister knyter AiQu ihop dem i en sammanhållen plattform.
Vi vill samtidigt vara ärliga: ingen plattform löser fälla 5. Ägarskap, processer och tydliga kvalitetsmått behöver organisationen själv bestämma. Det vi kan göra är att ge en grund där det blir enkelt att följa processerna, och att hjälpa till att sätta upp dem.
Ta nästa steg mot produktion
Att skala AI handlar mindre om nästa genombrott i modellerna och mer om att få grunderna på plats: spårbarhet, övervakning, en plan för drift, en infrastruktur som tål fler användare och ett tydligt ägarskap. Den som löser det tidigt får inte bara fler modeller i produktion, utan också modeller som går att lita på.
Få vår MLOps-checklista för produktion. Vi har sammanställt de frågor vi går igenom med våra kunder innan en modell går i drift, från spårbarhet och övervakning till ägarskap och omträning. Använd den för att se var era AI-projekt står i dag, och vilka steg som återstår.