NVIDIA Dynamo: Nästa generations AI-infrastrukturlösning för effektivare och mer skalbar inferens
NVIDIA har nyligen lanserat Dynamo, en öppen källkodslösning för AI-inferens som är utformad för att hantera och optimera stora språkmodeller (LLM) i distribuerade miljöer. Denna mjukvara representerar ett betydande steg framåt för organisationer som vill maximera prestanda och kostnadseffektivitet i sina GPU-baserade AI-infrastrukturer.
Vad är NVIDIA Dynamo?
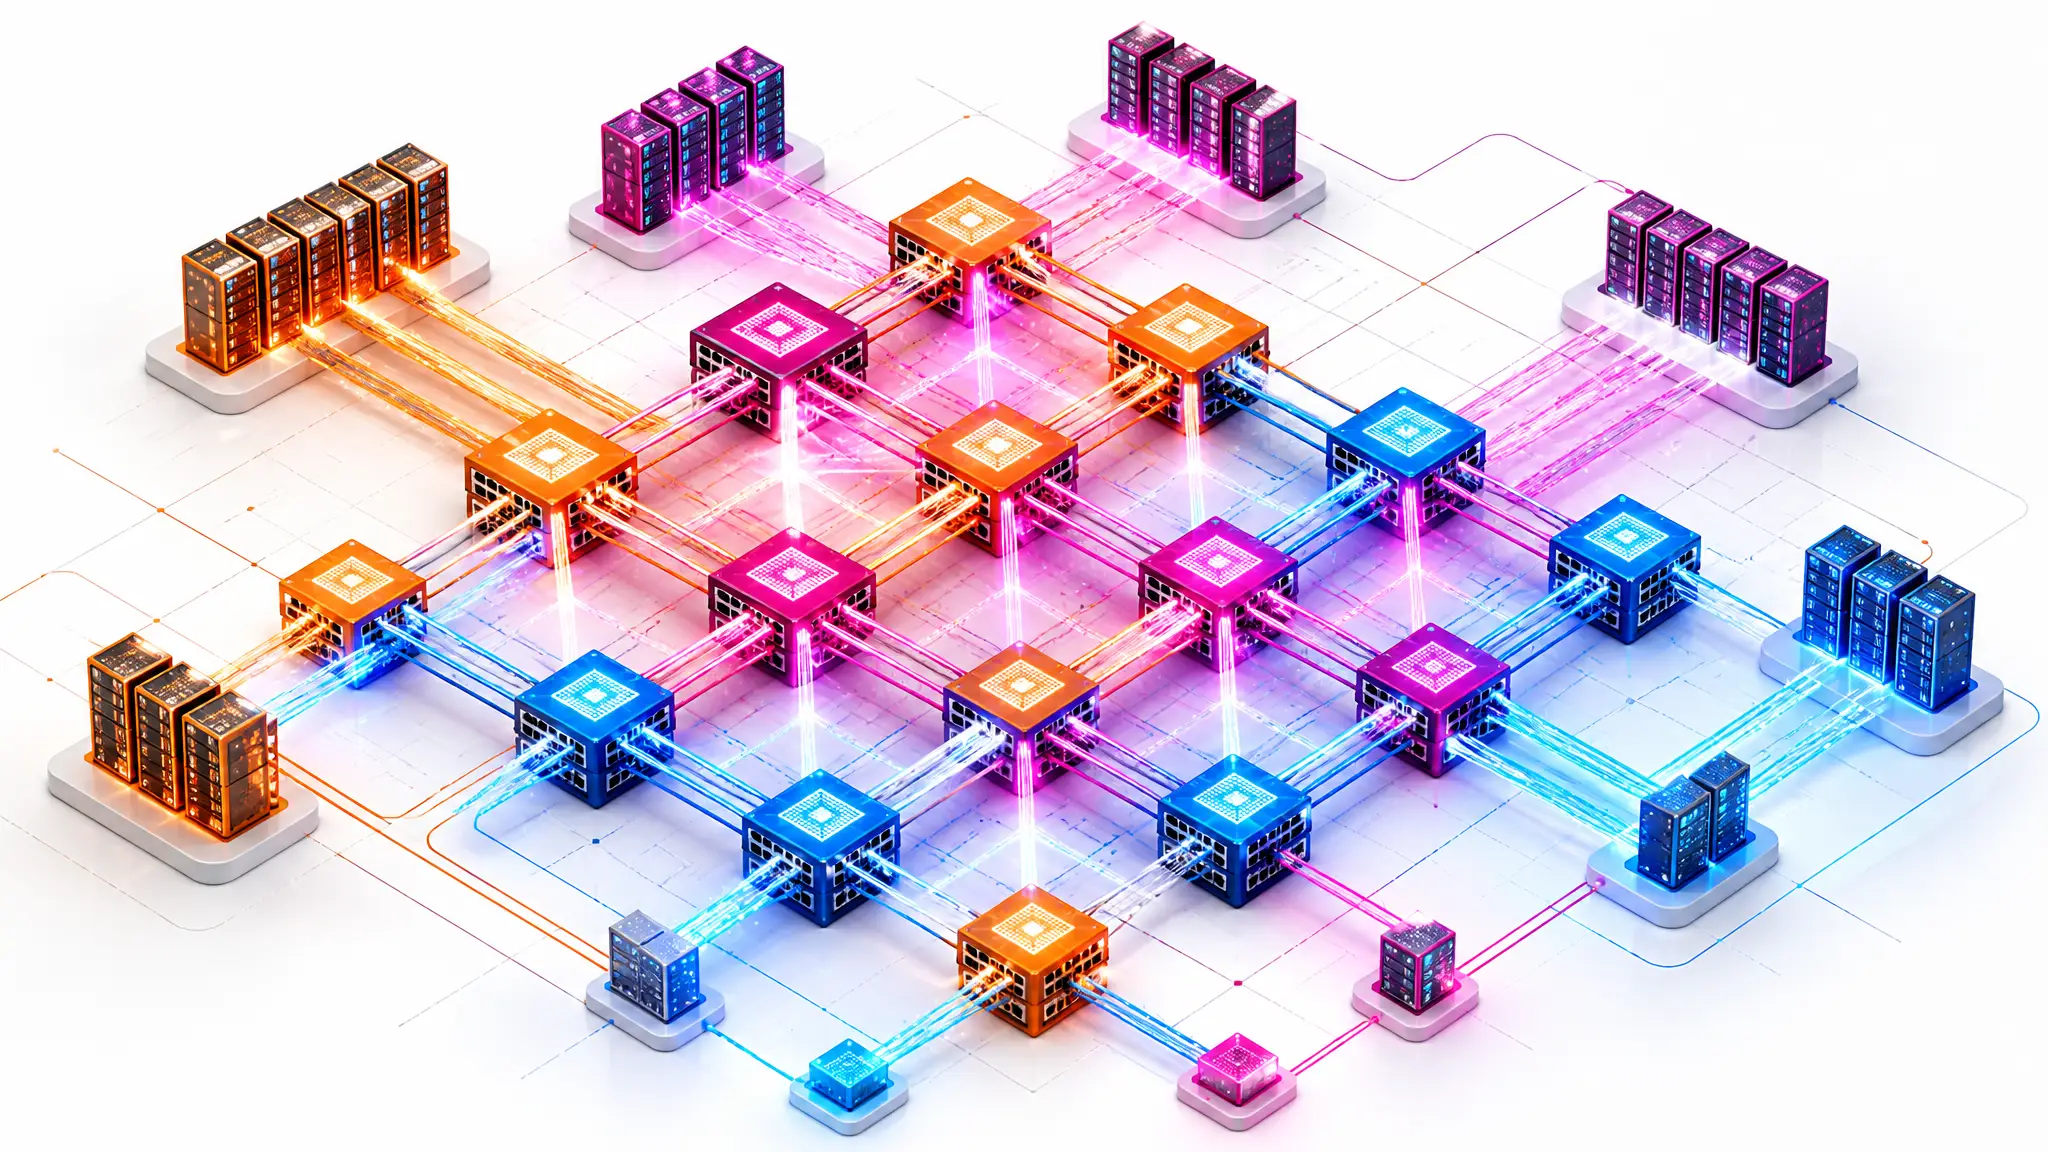
Dynamo är en modulär och låg-latens inferensplattform som möjliggör effektiv hantering av generativa AI-modeller över stora GPU-kluster. Den är designad för att skala sömlöst från enskilda GPU:er till tusentals, vilket gör den idealisk för företag som driver omfattande AI-applikationer.
Tekniska fördelar för IT- och AI-specialister
Disaggregated Serving: Separera förbearbetning och generering av LLM:er över olika GPU:er för att optimera resursanvändningen och öka genomströmningen.
Smart Router: Intelligent trafikdirigering som minimerar redundanta beräkningar och balanserar belastningen effektivt över GPU-flottor.
Dynamisk GPU-planering: Automatisk allokering av GPU-resurser baserat på realtidsbehov, vilket eliminerar flaskhalsar och förbättrar prestandan.
Stöd för flera inferensmotorer: Kompatibel med TensorRT-LLM, vLLM, SGLang, PyTorch och andra, vilket ger flexibilitet i val av backend.
Affärsfördelar för beslutsfattare
Kostnadseffektivitet: Genom att öka antalet inferensförfrågningar per GPU minskar Dynamo de totala driftkostnaderna för AI-applikationer.
Skalbarhet: Möjlighet att snabbt anpassa sig till förändrade affärsbehov genom dynamisk skalning av GPU-resurser.
Framtidssäker investering: Dynamo är en öppen och modulär plattform som enkelt integreras med befintliga AI-stacks, vilket skyddar tidigare investeringar och förenklar framtida uppgraderingar.
Prestanda i praktiken
Vid testning med den öppna modellen DeepSeek-R1 671B på NVIDIA GB200 NVL72 ökade Dynamo genomströmningen med upp till 30 gånger per GPU. När Llama 70B-modellen kördes på NVIDIA Hopper-plattformen fördubblades genomströmningen. Dessa förbättringar innebär att företag kan leverera AI-tjänster snabbare och till lägre kostnad.
Hur Aixia kan stödja din övergång till Dynamo
På Aixia erbjuder vi expertis inom implementering och optimering av AI-infrastrukturer. Vi kan hjälpa ditt företag att:
Utvärdera kompatibilitet: Analysera din nuvarande GPU-infrastruktur för att säkerställa att den är redo för Dynamo.
Implementera Dynamo: Stödja installation och konfiguration av Dynamo för att maximera prestanda och effektivitet.
Utbilda personal: Erbjuda utbildning för ditt team i användning och underhåll av den nya plattformen.
Kontakta oss för att diskutera hur vi kan hjälpa ditt företag att dra nytta av NVIDIA Dynamo och ta er AI-infrastruktur till nästa nivå.
För mer information om NVIDIA Dynamo, besök NVIDIA:s officiella sida.