AiQu och MLOps: Så stoppar du slöseriet med dyra GPU:er
Blogg | Aixia
95 % av GPU-kapaciteten gör ingenting. Samtidigt står data scientists i kö för att få köra sina modeller. AiQu är Aixias svar på ett av AI-världens dyraste problem.
Det är lätt att bli fascinerad av den senaste stora språkmodellen eller imponerande bildgenererare. Men bakom kulisserna i nästan varje AI-satsning finns ett betydligt mindre glamouröst problem: GPU:erna står tomma trots att teamen skriker efter beräkningskraft.
En färsk rapport från Cast AI bekräftar vad vi på Aixia sett under åratal – i genomsnitt används bara 5 % av den GPU-kapacitet som företag betalar för. Resten? Bokad men outnyttjad. Reserverad men overksam. Dyr men tom.
Varför slösas det bort så mycket?
Problemet är inte att företag köper för många GPU:er – det är att de hanterar dem som traditionella servrar i en värld där AI-workloads fungerar helt annorlunda.
Här är de tre vanligaste syndarna:
1. Statisk resursallokering
Vid midnatt körs ingen träning, men GPU:erna är fortfarande låsta till team som sover. Vid lunchtid är alla resurser upptagna och kön växer.
2. Manuell bokning via e-post och kalkylark
Data scientists begär GPU-tid i Slack-trådar. Någon glömmer släppa sin bokning. En vecka senare upptäcker man att en hel DGX har stått oanvänd.
3. Ingen insyn i utnyttjandegrad
Utan centraliserad översikt vet ingen hur mycket som faktiskt används. Budgeten godkänns baserat på gissningar, inte data.
Vad är AiQu – och varför är det annorlunda?
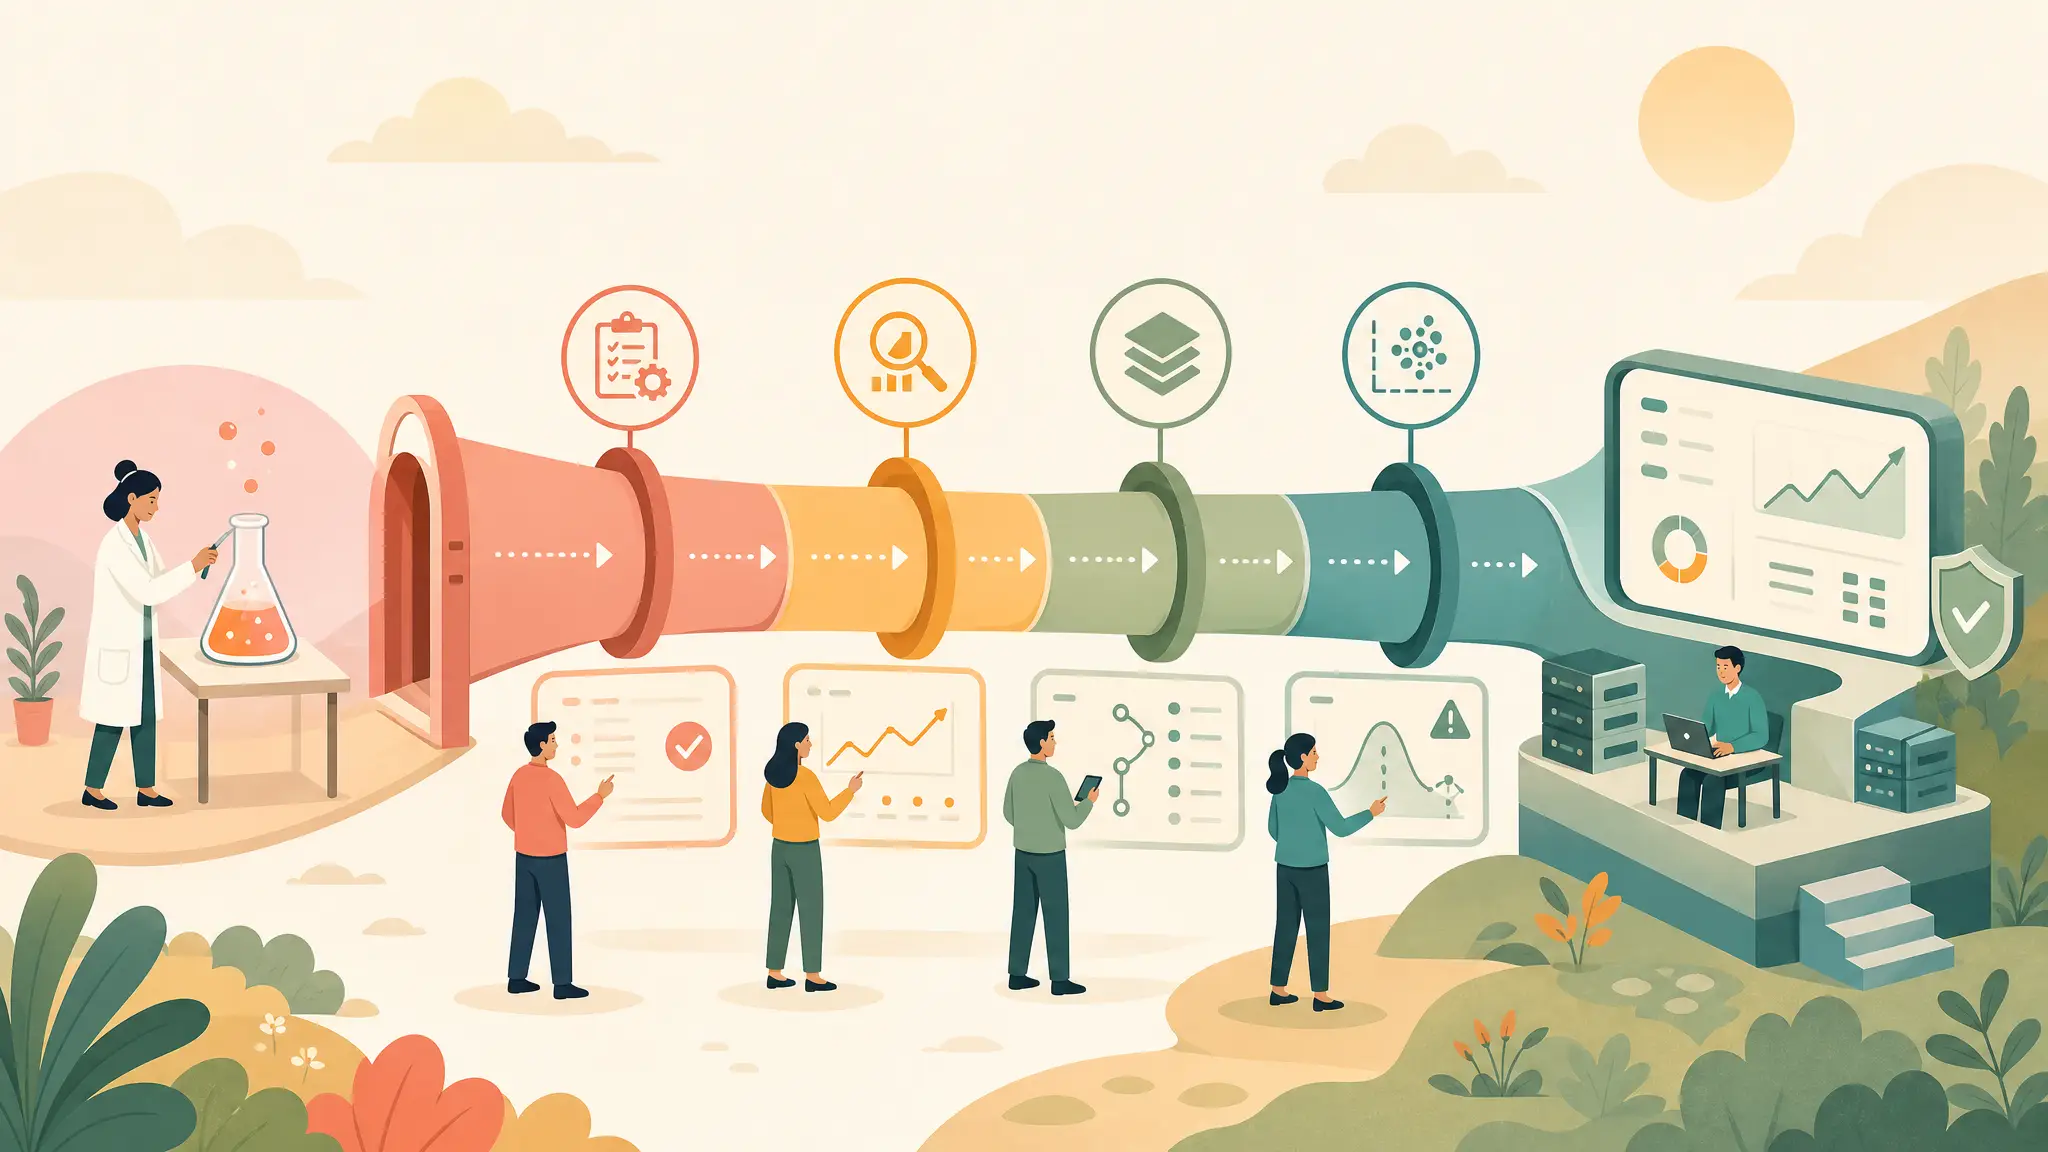
AiQu är Aixias MLOps-plattform, byggd för organisationer som inte accepterar att deras dyraste investeringar står och samlar damm. Plattformen förenar tre kritiska funktioner under ett tak:
🎯 Intelligent GPU-scheduling
AiQu fördelar workloads dynamiskt över tillgängliga GPU:er baserat på prioritet, kötid och resursbehov. Träning, inferens och experimentering delar samma pool effektivt.
📊 Fullständig observability
Se exakt vilka modeller som körs, vem som använder vilka resurser, och hur utnyttjandegraden förändras över tid. Ingen mer gissning – bara fakta.
🔒 Säker multi-tenancy
Olika team, projekt och kunder kan dela samma infrastruktur utan att komma åt varandras data eller modeller. Kritiskt för företag med höga säkerhetskrav.
On-prem är det nya molnet
En trend som accelererar är flytten tillbaka från molnet. 67 % av företagens AI-workloads körs nu utanför publika moln – och det finns goda skäl:
- Dataresidens: Känslig data lämnar aldrig huset
- Förutsägbara kostnader: Ingen överraskningsfakt på $50 000 för ” egress charges”
- Full kontroll: Du äger hårdvaran, infrastrukturen och policymakandet
- Hållbarhet: Svenska datacenter med fossilfri el slår molnregioner med kolbaserad energi
AiQu är designat för denna verklighet – en plattform som optimerar din on-prem GPU-infrastruktur lika smidigt som vilken hyperscale-tjänst som helst.
Marknaden växer – gör du det också?
MLOps-marknaden beräknas växa från 3,3 miljarder dollar 2026 till över 89 miljarder 2034. Det är ingen slump. Företag inser att modellerna är billiga – infrastrukturen är dyra.
Den som lyckas köra fler experiment, träna fler modeller och deploya snabbare med samma hårdvarubudget vinner AI-kapplöpningen. Den som fortsätter boka GPU:er via e-post förlorar den.
”Problemet är inte att vi saknar GPU:er. Problemet är att vi inte vet vilka som är lediga, vem som har bokat vad, och om någon ens använder dem.” – Så beskriver en AI-chef på ett stort svenskt industriföretag sin vardag före AiQu.
🚀 Börja optimera era GPU:er idag
På Aixia hjälper vi er att komma igång med AiQu – oavsett om ni har en handfull GPU:er eller ett helt DGX SuperPOD. Vi kartlägger er nuvarande användning, identifierar slöseriet och bygger en optimerad MLOps-plattform anpassad för era behov.
Publicerad av Aixia | 2026