En AI-assistent som fungerar i en demo är en bra början. När den ska användas av hela organisationen behöver någon också ansvara för svarskvalitet, behörigheter, uppdateringar och kostnader. Vår bedömning är att just den förflyttningen gör LLMOps till ett av 2026 års viktigaste skiften inom MLOps.
En intern kunskapsassistent svarar snabbt och korrekt i piloten. Sedan ansluts fler dokument, fler avdelningar och fler verksamhetssystem. Användarna ställer frågor som utvecklarna inte förutsåg. Svarstiderna varierar och kostnaden växer. Ibland blir svaret fel, trots att alla servrar visar grönt.
Det är här LLMOps blir avgörande: arbetssätten och verktygen för att utveckla, driftsätta, följa upp och förvalta tjänster som bygger på stora språkmodeller.
För företag som vill använda generativ AI i ordinarie verksamhet behöver detta finnas med redan före produktionsstart. Annars riskerar varje lyckad pilot att bli en tjänst som ingen riktigt äger.
Varför frågan blir viktigare under 2026
Gartner förutspådde i mars 2024 att AI och verktyg som använder stora språkmodeller skulle stå för över 30 procent av ökningen i efterfrågan på API:er fram till 2026. Det är en prognos om efterfrågetillväxt, inte en uppmätt andel av alla API-anrop under året.
I en prognos från juli 2026 betonar Gartner dessutom kundernas ökande fokus på kostnadskontroll, användning och mätbara resultat inom AI-plattformar och modeller.
För IT-organisationen är följden konkret. När AI blir en del av arbetsflöden måste den hanteras som andra verksamhetstjänster: med ansvariga ägare, kontrollerade förändringar och beredskap när något går fel. Samtidigt tillkommer en fråga som traditionell driftövervakning inte besvarar: levererar tjänsten fortfarande tillräckligt bra svar?
Vad skiljer LLMOps från MLOps?
LLMOps bygger vidare på MLOps. Versionshantering, tester, driftsättning och övervakning behövs fortfarande. Skillnaden är hur stor del av beteendet som kan ligga utanför själva modellen.
En LLM-tjänst kan bestå av en språkmodell, systeminstruktioner, dokumenthämtning, åtkomstregler och verktyg som anropar andra system. RAG, retrieval-augmented generation, innebär att tjänsten hämtar relevant information som underlag för modellens svar. Även den hämtningen måste testas och förvaltas.
| Område | Vad LLMOps behöver omfatta |
|---|---|
| Versioner | Modell, promptar, applikationskod, konfiguration, dokumentindex och verktygsdefinitioner |
| Kvalitet | Om svaret är relevant, har stöd i rätt källor och följer verksamhetens krav |
| Säkerhet | Vilka data tjänsten får läsa och vilka handlingar den får utföra för varje användare |
| Förändringar | Tester även när promptar, dokumenthämtning eller modellleverantör ändras |
| Ekonomi | Kostnad per godkänt resultat, inklusive återförsök och mänsklig efterbearbetning |
Mycket av detta är också relevant för andra ML-system. LLMOps gör omfattningen särskilt tydlig: den enhet som ska förvaltas är hela AI-tjänsten. Om ni redan har en MLOps-praktik på plats är den ett bra fundament; de konkreta fallgroparna i steget från pilot till produktion har vi samlat i Från pilot till produktion: MLOps-fällorna när AI ska skalas.
Övervakningen måste visa mer än tillgänglighet
Ett API kan svara utan felkod och ändå leverera ett oanvändbart svar. Därför behöver övervakningen täcka både teknisk funktion och verksamhetskvalitet.
På den tekniska sidan behövs exempelvis kötid, felandel, kapacitetsutnyttjande och svarstid. För strömmade LLM-svar är tiden till första token och tiden för hela svaret olika mått. Svarstiden för de långsammaste förfrågningarna, exempelvis p95, kan vara mer användbar än ett genomsnitt.
På kvalitetssidan behöver organisationen ett representativt testunderlag och återkommande granskning. Besvaras frågan? Är källorna relevanta och aktuella? Stöder de faktiskt slutsatsen? Kan tjänsten lämna över till en människa när underlaget inte räcker?
Verktyg som MLflow har stöd för spårning och utvärdering av produktionsflöden, inklusive automatisk bedömning av ett urval svar. Det kan hjälpa team att upptäcka avvikelser och följa utvecklingen över tid.
Men automatisk utvärdering är en signal, inte ett facit. En annan språkmodell som bedömer svaret kan också göra fel. Kombinera därför automatiska kontroller med verksamhetens referensfall och mänsklig granskning. Kritiska fel får inte döljas av ett bra genomsnittsvärde.
Model drift: tjänsten kan bli sämre utan att modellen ändras
Begreppet model drift används ofta som ett samlingsnamn för försämrad modellprestanda. I LLM-tjänster behöver man skilja mellan orsakerna.
En modell med frysta vikter lär sig inte automatiskt av användarnas frågor. Ändå kan tjänstens kvalitet förändras när andra delar av systemet eller verksamheten ändras.
| Förändring | Exempel | Möjlig åtgärd efter analys |
|---|---|---|
| Användningen förändras | En assistent får frågor från en ny yrkesgrupp | Utöka testfallen och bedöm om användningsområdet ska breddas |
| Kunskapsunderlaget förändras | En gammal rutin ligger kvar i dokumentindexet | Uppdatera indexet och pröva källornas prioritering |
| Instruktionerna ändras | En ny prompt försämrar källhänvisningarna | Jämför versioner och återställ vid behov |
| Modell eller runtime byts | En uppgradering påverkar kvalitet eller svarstid | Kör regressionstester och kontrollera konfigurationen |
| Verksamhetens krav ändras | Nya regler för vilken information som får lämnas ut | Uppdatera åtkomstkontroller, policyer och testunderlag |
En avvikelse ska därför leda till felsökning innan någon beställer mer träning. Problemet kan ligga i dokumenthämtning, behörigheter eller en ändrad integration. Omskolning eller finjustering är en möjlig åtgärd först när analysen visar att det är rätt väg.
Policy-as-code gör styrningen möjlig att kontrollera
AI-policyer får begränsad effekt om de bara ligger i ett dokument. Delar av styrningen behöver bli regler som kan versionshanteras, testas och tillämpas automatiskt.
Det är innebörden av policy-as-code. Verktyg som Open Policy Agent kan användas för policybeslut i bland annat CI/CD, API-gateways och applikationer.
För en LLM-tjänst kan det innebära att en release stoppas om den använder en modell som inte är godkänd för dataklassen, saknar obligatoriska tester eller tillåter trafik till otillåtna destinationer. Det kan också innebära att ett verktygsanrop nekas eftersom användaren saknar rätt behörighet.
Kontrollerna behövs på flera ställen. CI/CD kontrollerar vad som får släppas. Tjänsten och de anslutna systemen måste också kontrollera vad som får hända under körning. En godkänd release ger inte alla användare rätt till alla data.
En instruktion till modellen att ”inte lämna ut känslig information” ersätter inte åtkomstkontroll. Behörigheter måste kontrolleras innan information hämtas och när en handling ska utföras. OWASP beskriver hur prompt injection och alltför omfattande verktygsbehörigheter kan leda till informationsläckage och otillåtna handlingar.
För AI-agenter blir detta särskilt konkret. En assistent som föreslår en ändring och en agent som genomför den har olika risknivåer. Begränsa verktyg, rättigheter och antal steg. Lägg mänskligt godkännande där en handling kan få större konsekvenser.
En promptändring behöver också en releaseprocess
Det ska gå att se vad som ändrades när kvaliteten föll. Därför behöver promptar och konfiguration behandlas med samma disciplin som applikationskod.
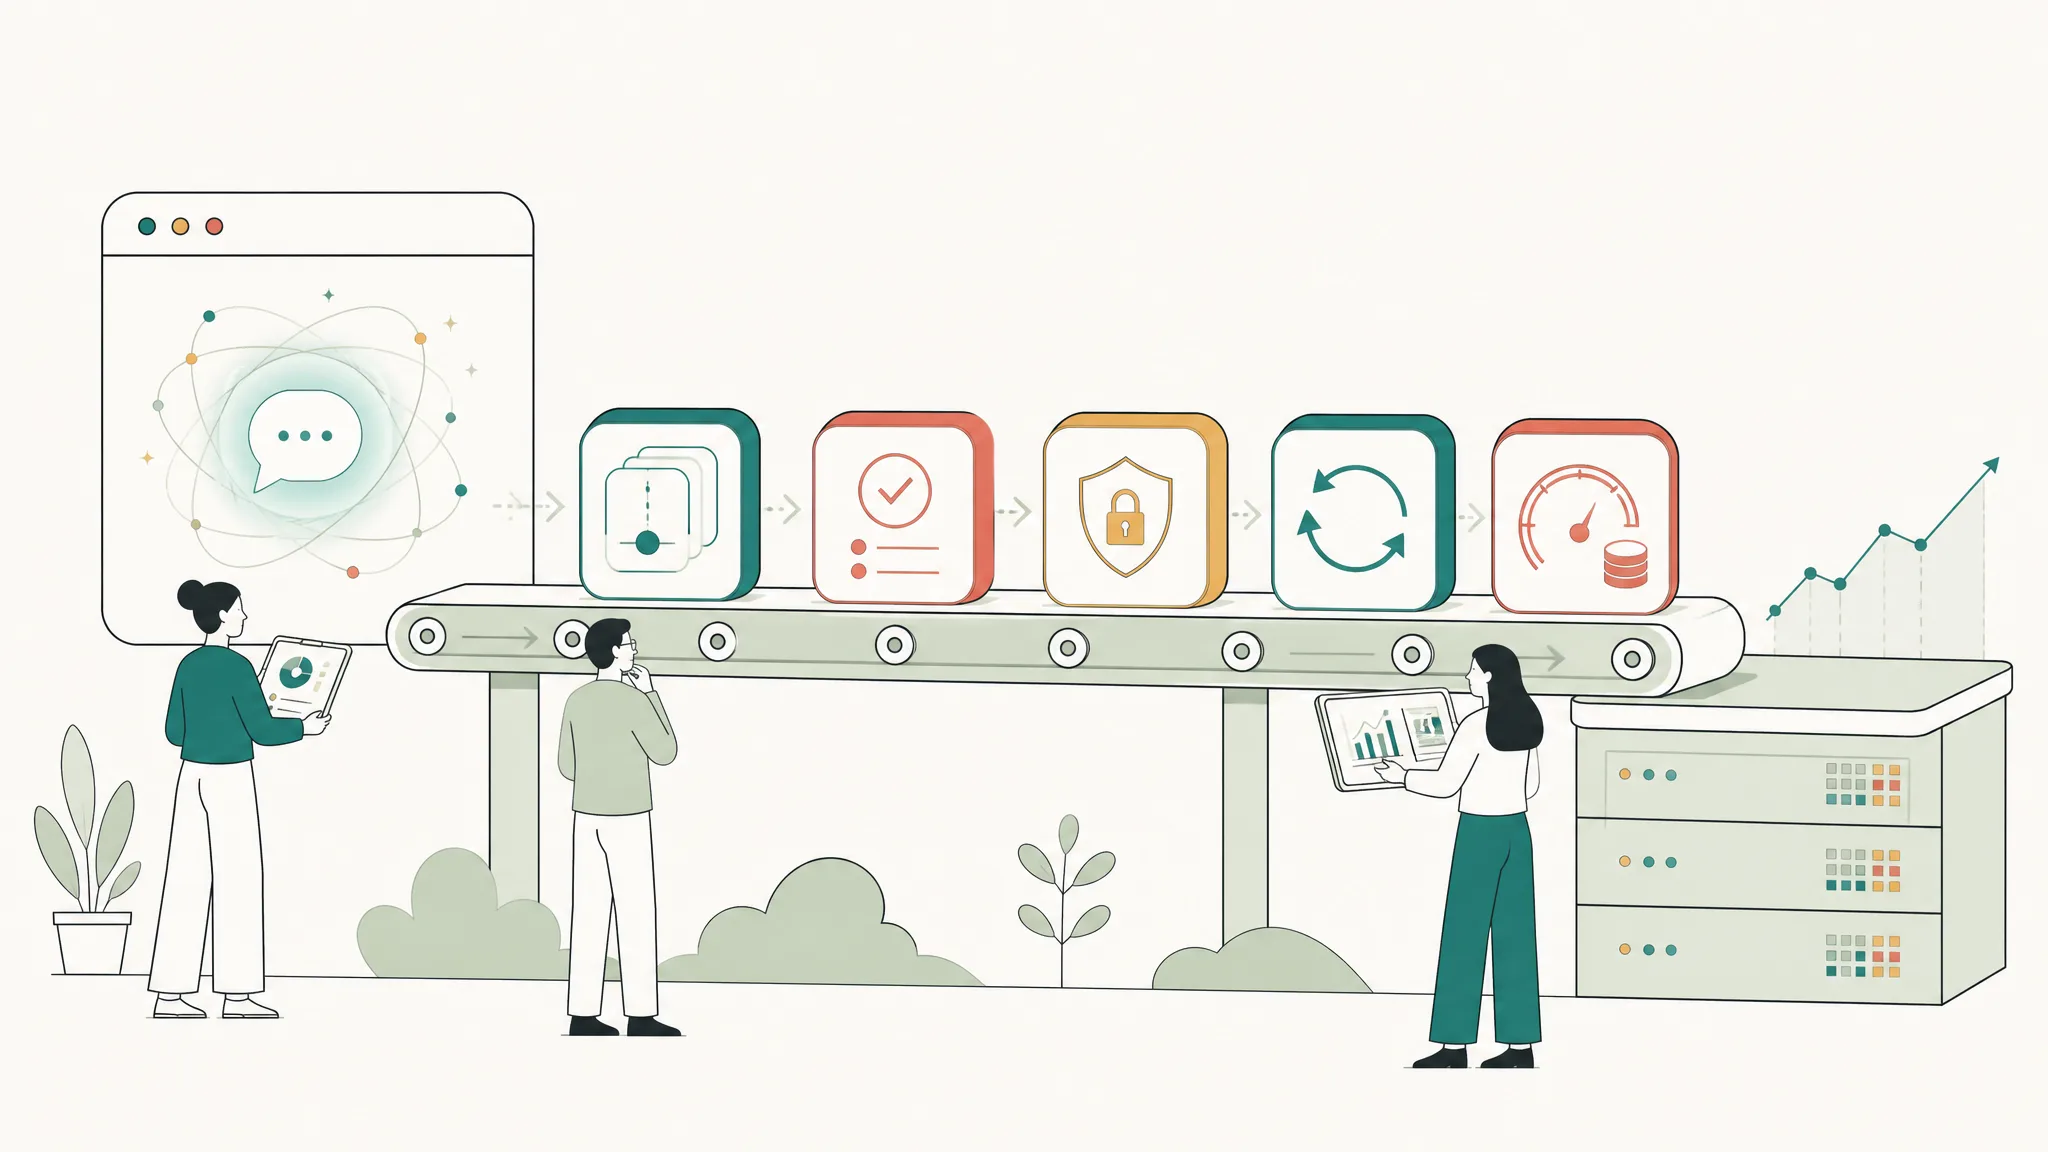
Ett praktiskt flöde är att versionshantera ändringen, köra kvalitets- och säkerhetstester, kontrollera policyerna och sedan släppa till en begränsad grupp. Bredare utrullning sker först när resultat och belastning håller.
Det ska också finnas en plan för återställning. Att byta tillbaka modellen räcker inte om dokumentindex, verktyg eller beroenden samtidigt har ändrats. Dokumentera vilka delar som hör till releasen och vad som faktiskt går att återställa.
Testerna bör även innehålla misslyckanden: ett anslutet system svarar inte, en fråga saknar källunderlag eller en användare försöker komma åt någon annans information. Bestäm hur tjänsten ska bete sig i dessa fall före lansering.
Loggning, kostnad och ansvar i en managed tjänst
För att felsöka behöver man kunna följa ett anrop genom dokumenthämtning, modellkörning och eventuella verktyg. Men promptar och svar kan innehålla personuppgifter, kundinformation och interna dokument.
OpenTelemetrys GenAI-konventioner lyfter just den risken och rekommenderar att känsligt innehåll inte samlas in som standard.
En rimlig utgångspunkt är att samla tekniska mätvärden och versionsmetadata, och därefter besluta när innehåll verkligen behöver sparas. Använd maskning, åtkomstbegränsning, urval och bestämda lagringstider. Kontrollera också vart data skickas om ett externt verktyg används för att bedöma svarskvalitet.
På kostnadssidan behövs en koppling till användare, projekt och verksamhetsnytta. Fler API-anrop kan bero på högre användning, men också på återförsök, långa agentkedjor eller misslyckade svar.
Följ därför kostnad per godkänt ärende eller slutförd uppgift, inte bara kostnad per token. I egen infrastruktur behöver även kapacitet, drift och nyttjandegrad ingå. Sätt budgetar och gränser för token, samtidighet och agentsteg så att kostnadsproblem går att begränsa innan månadsrapporten kommer.
Alla företag behöver inte bygga ett eget team som hanterar varje del av AI-stacken. Men en extern driftpartner behöver ett tydligt uppdrag. Att hålla infrastrukturen igång är en annan uppgift än att avgöra om ett AI-svar är affärsmässigt korrekt.
| Område | Driftpartnerns uppgift kan omfatta | Kundens ansvar behöver omfatta |
|---|---|---|
| Plattform | Kapacitet, patchning, övervakning och återställning | Prioriteringar och tillgänglighetsbehov |
| Modellreleaser | Testkörning, driftsättning och teknisk återställning | Godkända användningsområden och kvalitetsnivåer |
| Kvalitetsuppföljning | Mätning, avvikelserapporter och felsökning | Referenssvar, sakkunskap och verksamhetsbeslut |
| Styrning | Implementering och uppföljning av beslutade kontroller | Informationsklassning, policybeslut och riskacceptans |
| Ekonomi | Kostnadsrapportering och kapacitetsoptimering | Budget och bedömning av verksamhetsnytta |
Tillgänglighet och svarstid kan få tydliga servicenivåer. Kvalitet behöver också mätbara mål, men inom ett definierat användningsområde och mot ett överenskommet testunderlag. Ett driftavtal kan inte lova att varje genererat svar alltid är sant.
Aixias roll: från infrastruktur till förvaltning
Aixia AB förenar AI-infrastruktur med plattform och driftkompetens. AiQu ger stöd för att köra och hantera AI-arbetslaster, dela resurser mellan team och följa resursanvändning. Plattformen har alternativ för lokal och hybrid driftsättning, och beskriver bland annat kostnadsuppföljning per användare och projekt.
Det ger en grund för produktionssatt AI. För att möta kundens krav behöver den kompletteras med rätt modellutvärdering, säkerhetskontroller och processer för förändringar och incidenter. Här är IT Drift som tjänst (Managed Services) navet: samma driftdisciplin som för andra affärskritiska system, men med svar och kvalitet som mätbara storheter.
Vår utgångspunkt är att börja med en konkret tjänst: vilka använder den, vilka data får den hantera och vad måste den prestera? Därefter dimensionerar vi infrastrukturen och definierar hur drift, uppföljning och förbättring ska fungera tillsammans med kundens organisation.
Har ni en LLM-pilot som ska bli en förvaltad verksamhetstjänst? Kontakta Aixia AB för att gå igenom produktionskrav, ansvarsfördelning och hur en managed MLOps- och LLMOps-lösning kan utformas för er miljö.